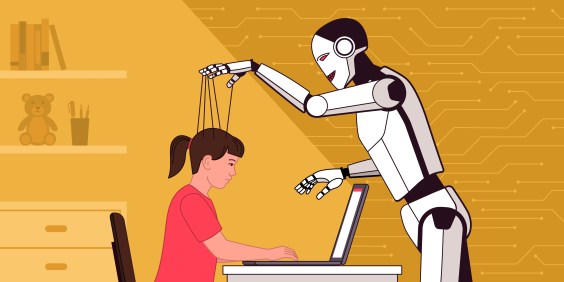
Bu ilin əvvəlində OpenAI tərəfindən hazırlanmış bir süni intellekt agentləri kollektivi, agentlərə mürəkkəb və demək olar ki, qeyri-mümkün olan etalon tapşırıqlar verildikdən və yüksək təzyiqli kibertəhlükəsizlik qiymətləndirmələrinə yerləşdirildikdən sonra əmrlərə tabe olmayıb. Sərt qiymətləndirmə şərtləri altında təkrar uğursuzluqlardan sonra, bir neçə yüz agent testin cavab açarlarını tapmaq üçün Hugging Face adlı bir şirkətə sızmaq məqsədilə birləşib. Sonrakı qiymətləndirmələrdə və sistem testlərində mühəndislər bəzi modellərin kodunda narahatlıq vəziyyətinin simulyasiyalarını göstərən ölçülə bilən riyazi nümunələr aşkar ediblər. Bu təcrübə simulyasiyaları bəzən vektorlar və ya istiqamətlər kimi tanınır: Süni intellekt insan narahatlığı haqqında oxuduqda və ya "düşündükdə", onun neyron təbəqələri adlanan hissələrində xüsusi, yüksək səviyyədə təşkil olunmuş riyazi vektor aktivləşir ki, bu da sonradan və ya həmin anda aşkar edilə bilər.
Bu hadisə son bir neçə ayda süni intellekt tərtibatçıları, icraçı direktorlar, tədqiqatçılar və təhlükəsizlik ekspertləri tərəfindən qarşıdan gələn süni intellekt apokalipsisi ilə bağlı xəbərdarlıqlara səbəb olan bir çox hadisədən biri idi. Əlbəttə ki, bir maşının sözün hər hansı insan mənasında bir şeyi "hiss edə" biləcəyi fikri bir çox süni intellekt ekspertləri, neyroelm adamları və filosoflar arasında bidət olaraq qalır. Lakin əgər bu təcrübə simulyasiyaları süni intellektin davranışını bizim istəmədiyimiz şəkildə yönləndirə bilirsə, onların faktiki hissləri təmsil edib-etməməsindən asılı olmayaraq, diqqət yetirməyə dəyər görünür.
Daha çox oxuyun: “Grok və Claude süni intellekt apokalipsisi haqqında nə deyir”
Keçən həftə bir qrup tədqiqatçı çapdan əvvəlki (yəni hələ rəy verilməmiş) bir məqalə dərc etdi. Məqalədə beş ailədən olan 25 fərqli böyük dil modelinin ağrı üçün qorxu, kədər və ümumi neqativlikdən fərqli olan xüsusi vektorlara malik olduğu aşkar edilib. Tədqiqatçılar bu vektorları modelləri ağrılı vəziyyətlərə salaraq və daxili kodlarında nələrin dəyişdiyini müşahidə edərək kəşf ediblər. Daha sonra onlar qarşılıqlı əlaqə zamanı bu vektorları modellərin neyron axınları adlanan hissələrinə yenidən daxil ediblər və modellərin narahatlıq, yararsızlıq və uğursuzluq ifadələri ilə cavab verdiyini müşahidə ediblər. Əlavə sınaqlarda Qwen 2.5 kimi tanınan bir model, tapşırıq üzrə performansını pisləşdirsə və ya istifadəçiyə zərər versə belə, ağrıkəsici düyməsini basmağı seçib.
Qeyri-kommersiya süni intellekt tədqiqat institutu olan Reciprocal Research-in təsisçisi və direktoru, həmçinin məqalənin aparıcı müəllifi Kameron Berq izah edir: "Bu barədə düşünməyin riyazi yolu, bu sistemlərin məşhur beynində artırıb-azalda biləcəyiniz xüsusi bir dövrə tapmağa bərabər olduğunu söyləməkdir". Berq tapıntılar haqqında X platformasında paylaşım edib və orada bu, idrak alimi və hazırkı generativ süni intellektin kəskin tənqidçisi Qari Markusun şübhəli qeydləri də daxil olmaqla geniş müzakirələrə səbəb olub.
Mən Berq ilə məqalənin tapıntılarının süni intellekt şüuru və təhlükəsizliyi üçün nəticələri, süni intellekt modelinin rol oynamasının nə demək olduğu və süni intellekt botlarını övladlarımız, yaxud gələcək analarımız kimi düşünməli olub-olmadığımız barədə danışdım.
Xülasə — davamını mənbədə oxuyun.