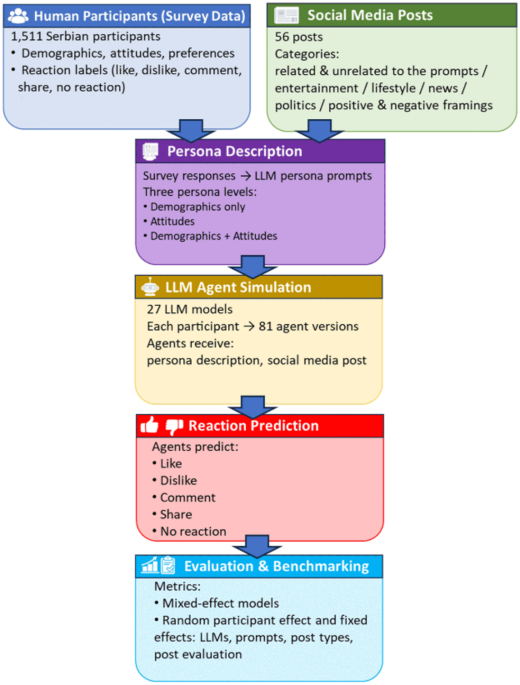
Sosial media platforması milyardlarla insanın fikirlərini necə formalaşdırdığını və ictimai danışıqlarla necə məşğul olduğunu vasitə edir. Avtonom süni intellekt agentləri bu məkanlarda getdikcə daha çox iştirak etdikləri üçün davranış sadəliyini anlamaq platforma idarəetməsi və demokratik davamlılıq üçün kritik hallara çevrilir. Əvvəlki işlər göstərir ki, LLM-ə malik agentlər ümumi sorğu cavablarını təkrarlaya bilərlər, lakin az tədqiqatlar agentlərin müəyyən şəxslərin müəyyən məzmunlara reaksiyalarını proqnozlaya biləcəyini yoxlayır. Bu tədqiqat, 1511 serb iştirakçısından və 27 böyük dil modelindən əldə edilmiş 120,000+ unikal agent-şəxsi birləşmədən ibarət olan insan sosial media reaksiyalarının (məsələn, bəyənmə, şərh, heç bir reaksiya) proqnozlaşdırılmasında LLM əsaslı agentlərin dəqiqliyini ölçür. 1-ci tədqiqatda agentlər ümumi dəqiqliyi 70,7% -ə çatdırıblar və LLM seçimi 13% -lik performans yayımını təmin edib. 2-ci tədqiqatda şansla düzəldilmiş ölçülərlə ikitərəfli məcburi seçim (sevirmək və sevməmək) qiymətləndirilməsi istifadə edilmişdir. Agentlər Matthews Correlation Coefficient (MCC) -i 0.29 -a çatdırıblar. Bu da təsadüfdən kənarda həqiqi proqnozlaşdırıcı siqnal göstərir. Bununla birlikdə, TF-IDF təmsillərini istifadə edən ənənəvi mətn əsaslı nəzarət edilmiş təsnifçilər LLM agentlərindən (MCC 0,36) üstünlük təşkil edirdi, bu da göstərir ki, prediktiv siqnal fərdi davranış simulyasiyası üçün hər hansı bir qabiliyyətdən daha çox semantik mətn məzmunundan irəli gəlir. Zero-shot persona-prompted agentlərin həqiqi, lakin mütevazi proqnozlaşdırıcı etibarlılığı göstərir ki, hazırda dəqiq fərdi hədəfləmə üçün dəqiq dəqiqlik yetərli olmasa da, təsadüfdən yuxarı dərəcədə reaksiyaların proqnozlaşdırılması qabiliyyəti süni intellektə yönəlmiş təsir və sosial simulyasiya metodologiyası müzakirələrində diqqət tələb edir. ZERO-shot agentlərinin üstünlüyü ondan ibarətdir ki, onlar xüsusi vəzifələrə təlim tələb etmirlər və bu da seçki kampaniyaları və kütləvi manipulyasiya da daxil olmaqla müxtəlif kontekstlərdə geniş miqyaslı tədarükü asanlaşdırır. Sərhədlər bir ölkə üçün nümunə götürülməsini əhatə edir. Gələcək tədqiqatlar çoxdilli test və incə tənzimləmə üsullarını araşdırmalıdır.
Böyük dil modellərinin (LLM) sosial və davranış tədqiqatlarında insan iştirakçılarının təmsilçiləri kimi fəaliyyət göstərə biləcəyi fikri bir neçə il ərzində spekulativ təklifdən sürətlə genişlənən tədqiqat proqramına keçib. Park1 25 LLM-ə əsaslanan qəmli bir mühitdə yaradıcı agentləri yerləşdirdi və onların sosial tədbirləri təşkil etdiklərini, münasibətləri qurduqlarını və insan müşahidəçilərinin inanılmayacaq hesab etdiyi şəkildə gündəlik rutinləri əlaqələndirdiyini tapdı. Böyük miqyaslı davranış məlumatları üzərində təlim olunan əsas modelləri isə o vaxtdan müxtəlif paradigmalarda biliş səviyyəsində proqnozlaşdırma əldə etdi2. Bu ilk konsepsiya sübutu daha iddialı layihələrə yer verdi. Park3 1,052 nəfərlə iki saatlıq müsahibələrdə yaradıcı agentləri yerləşdirdi və ümumi sosial sorğunun cavablarını iştirakçıların 85%-nin iki həftəlik test-reset test dəqiqliyi ilə təkrarladı. Yang və digərləri isə bir milyon agentə qədər OASIS platforması üzrə yanaşmayı ölçdü. Bu inkişaflar birgə göstərir ki, LLM əsaslı sosial simulyasiya siyasət müdaxilələrini yoxlamaq, fikir dinamiklərinin modelləşdirilməsi və real istifadəçi təcrübələrinin praktik olmayan və ya etik olmayan stress test platformasının dizaynı üçün ümumi məqsədli bir vasitə ola bilər5.
Əmək xətti ilə tamamlayan bir sahədə Altera.AL6 Layihə Sid-i təqdim etdi və göstərdi ki, Minecraft mühitində yerləşdirilən 10 ilə 1000-dən çox LLM-ə malik agent müstəqil olaraq ixtisaslaşmış peşəkar rollar inkişaf etdirə bilər, demokratik proseslər vasitəsilə kollektiv qaydalara riayət edə və dəyişdirə bilər və bir çox simulyasiya cəmiyyətində mədəni və dini ötürmə ilə məşğul ola bilər. Bu, ortaya çıxan sosial təşkilatın cəmiyyət quruluşlarının açıq proqramlaşdırılmaması olmadan da əldə edilə biləcəyini göstərir.
Rəqəmsal izlərdən insan davranışının proqnozlaşdırıla biləcəyi bir on ildən çoxdur öyrənilməkdədir. Kosinski və digərləri.7 nümayiş etdirdilər ki, yalnız Facebook Likes həssas şəxsi xüsusiyyətləri yüksək dəqiqliklə proqnozlaya bilər. Daha son zamanlarda Derner və digərləri, ChatGPT-nin model çıxışındakı positivity bias sənədləşdirməsinə baxmayaraq, insan qiymətləndiricilərinə müqayisə edilə bilən qısa mətnlərdən Böyük Beş şəxsiyyət xüsusiyyətlərini nəticələyə biləcəyini göstərdilər.
Bununla belə, bu tədqiqat proqramının empirik əsasları incə qalır və sübut edilmiş bacarıq və təsdiq edilmiş etibarlılıq arasındakı fərq böyükdür. Mövcud işlərin çoxu LLM agentlərini ümumi sorğu paylamalarını təkrarlamaq və ya insan qiymətləndiriciləri inanılmazdır deyə hesab edən mətni yaratmaq qabiliyyətinə görə qiymətləndirmişdir, lakin nisbətən az tədqiqatlar LLM agentlərinin müəyyən növ insanların müəyyən məzmun növlərinə xüsusi davranış reaksiyalarını dəqiq olaraq proqnozlaya biləcəyini soruşdu (oxuya bilərsiniz). Bu fərq vacibdir. Toplu dəqiqlik alt qruplar, məzmun növləri və ya persona konfigürasiyaları səviyyəsində sistemli uğursuzluqları gizlədə bilər və bu cür uğursuzluqlar məqsədi təmiz dənəli davranış proqnozu olan istənilən tətbiq üçün LLM əsaslı simulyasiyanın faydalılığını ciddi şəkildə məhdudlaşdırır.
Bu narahatlığın mərkəzində LLM agentlərinin təyin edilmiş şəxsiyyətləri necə sadiq şəkildə təmsil edə biləcəyi sual yerləşir. Əsas şərtləndirmə üsulu persona təzyiqi, burada nümunə s demografik, münasibət və ya psixoloji profilinin bir mətni təsviri model s girişə əlavələrə qoyulur10,11. Argyle10 göstərdi ki, GPT-3-nin Amerikanın Milli Seçki Araşdırmaları tərəfindən demografik tarixlərə əsaslanmasının nəticəsində insan alt qrupunun cavablarını izləyən fikir paylanması meydana gəldi. Nəticədə onlar silicon nümunə götürmə, və Törnberg və digərləri, konvensional dizaynlardan daha çox tərəflərarası dialoqun inkişaf etdirildiyini göstərmək üçün 500 persona əsaslı agentlərlə simulyasiya platformasını doldurdular. Daha sonra iş bu optimizmə mane olur. Hu və digərləri12 persona dəyişikliklərinin əksər vəzifələrdə insan qeydlərinin 10% -dən az dəyişikliyi izah etdiyini və müəyyən qazancların orta qeydçi anlaşmazlığı məlumat dəstlərində cəmləşdiyini və Liu və digərlərinin bildirdiyinə görə13 agentlər qeyri-müvafiq personalara doğru yönəldildiyini bildirdilər.
Xülasə — davamını mənbədə oxuyun.


