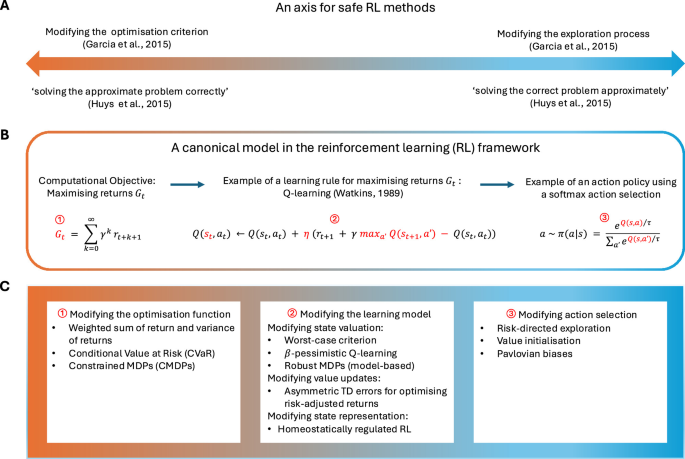
Sağ qalmaq yalnız mükafatların maksimum dərəcədə artırılmasından deyil, zərərin minimuma endirilməsindən asılıdır. Qeydiyyatlı öyrənmə (RL) uyğun qərar qəbul etmək üçün normativ bir çərçivə təmin edərkən, standart algoritmalar tez-tez heyvanlar kimi öyrənmə zamanı səhvlərin fəlakətli xərclərini nəzərə almır. Bu baxışda təhlükəsiz RL-nin mühəndisliyi ilə davranış və sistemli nevrologiyaları əlaqələndirən son inkişafları sintez edirik. Biz iki strategiya arasındakı prinsipial taksonomiyanı qəbul edirik: (1) təhlükəsizliyi öyrənmə məqsədi ilə əhatə etmək üçün optimallaşdırma meyarını dəyişdirmək və (2) təhlükəli hərəkətlərin qarşısını almaq üçün kəşfiyyat prosesini dəyişdirmək. Biz göstəririk ki, ən pis hal optimallaşdırılması, risk həssaslıq hədəfləri (məsələn, riskdə şərti dəyər, CVaR) və məhdud Markov qərar prosesləri (MDP) kimi mühəndislik həlləri narahatlıq, risk qarşısını almaq və müdafiə refleksləri üçün dəqiq hesablama hesablarını təklif edir. Əksinə, təbii əvvəlcədən, interocepsiya və qeyri-müəyyənlik, etibarlılıq və rəqabət tələblərinə əsaslanan meta-kontrol daxil olmaqla bioloji mexanizmlər süni vasitələrdə təhlükəsiz araşdırma probleminə güclü həll təklif edir. Bu sahələri birləşdirərək, təhlükəsizliyin reaktiv istinclər və düşüncəli planlaşdırma arasında dinamik bir qarşılıqlı təsir yolu ilə əldə ediləcəyi bir hesablama mənzərəni vurğulayırıq.
təhlükəsiz öyrənmə anlayışı ilk baxışdan paradoksal görünə bilər. Təcrübədən öyrənmək mütləq səhvlər etməyi tələb edir, lakin bəzi səhvlər, məsələn, ciddi xəsarət və ya ölüm, o qədər fəlakət törədən ola bilər ki, daha çox öyrənməyə mane olur. Bu, hər hansı bir ağıllu, bioloji və ya süni vasitə üçün əsas bir sual doğurur: potensial olaraq qaytaraqsız zərər riskini minimuma endirərək təcrübədən necə öyrənmək olar?
Əvvəlki işlər göstərir ki, bu dilemmanı həll etmək üçün iki görünən tamamlayıcı qabiliyyət tələb olunur. Birincisi təhlükəsiz araşdırma: xarici təhlükələrdən qaçınarkən məlumat toplamaq üçün qeyri-müəyyən mühitlərdə ehtiyatlı davranmaq qabiliyyəti. İkincisi, özünü qorumaqdır: homeostatik lütfdən kənarlaşmaları, yəni heyvanın xəsarət alması və ya robotun komponentindəki səhv kimi daxili təhdidləri aşkar etmək, təmsil etmək və cavab vermək qabiliyyəti1. Təhlükəsiz araşdırma xarici təhlükələrlə əlaqəli olsa da, özünü qorumaq daxili bütövlüyün qorunmasına diqqət yetirir. Həm təhlükəsiz kəşfiyyat, həm də özünümüdafiə, qeyri-müəyyən fiziki dünyada sağ qalma şanslarını maksimum dərəcədə artırmaq istəyən heyvanlar və digər ağıllı maşınlar üçün prioritetdir. Bu imkanları hesablama yolu ilə öyrənməyin bir yolu təhlükəsiz gücləndirilmə öyrənməsinin obyekti vasitəsilədir2. Son zamanlar bu cür hesablama yanaşmaları neuro-hissəviyyəli modelləşmə və insan hesablama psixiatriyasında3, xüsusilə də qorxu, narahatlıq, panik, qaçınma, təcavüz və yenidən düşünmə sahələrində, eləcə də hesablama psixiatriyasının prinsiplərini kompüterlərə və ya ağıllı maşınlara tətbiq etməkdə daha da əhəmiyyətlidir5.
Əvvəlki əhəmiyyətli işlər bu hesablamaları təhlükənin məkan və vaxt yaxınlığı ilə dəyişən həddən artıq həddən artıq həddən artıq təhlükə qarşısını alan təhlükə-hücumluq kontinuumu boyunca xəritələyib6.7. Təhlükəsiz davranışların əhəmiyyətli bir hissəsini həssas yırtıcı heyvanlardan qaçışlar təşkil etsə də8, bu baxış ümumi xarici zərərlərdən öyrənməyə diqqət mərkəzindədir (bəzən itkilər və ya cəza kimi qəbul edilir). Biz təhlükəsiz davranışların daha geniş kontinuumunu araşdırırıq: risk qarşısını almaq və narahatlıq əsasında olan əvvəlcədən hesablamalardan travmadan sonra meydana gələn özünü qoruyuculuq hərəkətlərinə qədər, məsələn, xəsarət9. Həm əvvəlcədən, həm də travmadan sonra olan sahələri birləşdirərək, hesablama nevrologiyalarında araşdırılmamış sahələri hesablama psixiatriyasına birbaşa tətbiq etmək məqsədi daşıyırıq.
İlk olaraq, kanonik RL çərçivəsini və müxtəlif təbii bilik formalarını birləşdirmək təhlükəsiz davranışların öyrənilməsini necə formalaşdırdığını təqdim edirik10. Kanonik RL çərçivəsi və Garcıa və Fernández2 taksonomisi əsasında, biz daha sonra ümumi təhlükəsiz gücləndirilmə öyrənmə metodlarını bu kanonik çərçivənin dəyişiklikləri kimi şərh və kateqoriyaya qoyacağıq. Bunu edərək, optimallaşdırma meyarını dəyişdirən metodların davranışlı nörologiya elmlərinə necə tətbiq edilməsini və davranışlı nörologiya nəticələrinin kəşfiyyat prosesini dəyişdirən metodlara necə dərk etməsini vurğulayırıq. Bu cür bir disiplinlərarası yanaşmanın imkan verdiyi möhkəm suallar və gələcək istiqamətlər ilə baxışın sonuna çatırıq.
Qeydiyyat öyrənmə (RL) agentlərin mükafat və ya cəzalardan geri bildirmə istifadə edərək qeyri-müəyyən mühitlərdə necə davranmağı öyrənmək üçün riyazi bir çərçivə təmin edir. Əsasən, agent bir vəziyyətə nəzarət edir, bir hərəkət edir və mühitdən mükafat və yeni bir vəziyyət alır. Zamanla agent, bir pul pul pulunu da adlandırılan toplu (diskontu) mükafatını maksimum dərəcədə artıran bir siyasət öyrənməyi, dövlətlərdən hərəkətlərə xəritələməni hədəfləyir11.
Xülasə — davamını mənbədə oxuyun.


